Viele Software-Entwickler kennen es. Ein Softwareprojekt läuft schon eine ganze Weile, und es wird immer schwieriger neue Features zu implementieren und Bugs zu fixen. Zu Beginn des Projektes wurden Features schnell implementiert, ohne auf Codequalität zu achten. Und auch wenn das Team sich Mühe gibt, ist unsauberer Code nicht vermeidbar. Es häuft sich technische Schuld an. Um diese technische Schuld zu begleichen, muss der Code überarbeitet werden. Denn wenn das nicht passiert, wird es schon bald kaum möglich sein mit dem bestehenden Code zu arbeiten.
In meinen allerersten Job hatte ich ganz besonders mit dem Problem von Legacy Code zu kämpfen. Ich hatte die Aufgabe einen Bug zu fixen. Ein HTML-Element wurde nicht korrekt angezeigt. Nun schien es für mich offensichtlich, dass der Bug sich unmittelbar an der Stelle befinden muss, wo sich das Element definiert oder befüllt wird. Schnell musste ich feststellen, dass es nicht so einfach werden würde, den Bug zu fixen, denn als ich mir den Code genauer angesehen habe, konnte ich das seltsame Verhalten des HTML-Elements einfach nicht erklären. Nach langer Suche musste ich entsetzt feststellen, dass an einer anderen Stelle im Code global und dynamisch ein Stylesheet geladen wurde, was zur Folge hatte, dass das HTML-Element falsch angezeigt wurde. Der Bug hat mich einen ganzen Tag gekostet und sehr, sehr viele Nerven. Aber heute weiß ich: es geht auch anders.
Es gibt verschiedene Möglichkeiten mit Legacy Code, also altem Code, zu arbeiten. Grundsätzlich kann gibt es drei Arten Code zu ändern: Es können neue Features implementiert werden, es kann bestehender Code umstrukturiert werden, und es kann bestehender Code refactored werden. Wo liegt hier der Unterschied?
Beim Implementieren neuer Features wird zusätzlicher Code geschrieben. Es werden also zusätzliche Logiken implementiert. Diese reiht sich hoffentlich, aber nicht zwangsläufig, sauber in den bestehenden Code ein, sodass die bestehende Logik nicht verändert wird. Beim Umstrukturieren (Restructuring) von Code soll bestehender Code umgeschrieben. Dabei kann sich die Logik des bestehenden Codes auch gerne ändern, und vielleicht ist dies auch gewünscht. Beim Refactoring soll, wie beim Restructuring, der bestehende Code umgeschrieben werden, aber die Semantik, also die Logik, des Codes, soll sich dabei nicht verändern. Die Anzahl der möglichen Operationen, die beim Refactoring auf einer Codebase stattfinden können, ist also deutlich begrenzter als beim Restructuring oder beim Implementieren neuer Features.
Eingangs wurde über die Problematik gesprochen, dass sich in lange laufenden Softwareprojekten mit der Zeit immer mehr technische Schuld anhäuft. Nun hat technische Schuld erstmal nichts damit zu tun, dass die Software nicht so funktioniert wie sie sollte. Vielmehr bedeutet der Begriff, dass es schwer ist mit dem bestehenden Code zu arbeiten. Und Refactoring soll genau dieses Problem lösen. Die Funktionalität der Software soll genau so bleiben, wie sie ist, aber die Code Qualität soll zunehmen.
Wie läuft ein Refactoring ab?
Um Code erfolgreich zu refactoren, muss es eine Möglichkeit geben zu prüfen, dass sich durch eine Änderung die Funktionalität der Software nicht verändert hat. Dafür brauchen wir Tests. Wenn der Codeabschnitt, den wir refactoren wollen, noch nicht getestet ist, dann müssen wir zuerst Tests schreiben, bevor wir mit dem Refactoring anfangen können. Das initiale Schreiben des Tests kann dabei eine ganz schöne Herausforderung sein. Immerhin arbeiten wir mit Legacy Code, und vielleicht verstehen wir nicht einmal, was der Code, den wir refactoren wollen, eigentlich anstellen soll. Es bietet sich also an, zuerst einmal ein wenig mit dem Code herumzuspielen, ihn zu refactoren, aber am Ende alle Änderungen wieder zu reverten. Dadurch bekommen wir ein besseres Verständnis für den Code. Mit dem neugewonnenen Verständnis schreiben wir nun Tests. Sobald wir die nötigen Tests geschrieben haben, um den Code, den wir refactoren wollen, abzudecken, können wir mit dem Refactoring beginnen. Das Refactoring selbst läuft nun in drei Schritten ab:
Wir führen ein atomares Refactoring aus
Wir führen die Tests aus
Wenn, alles erfolgreich war, erstellen wir einen neuen commit, ansonsten reverten wir die Änderungen
Da wir nun die Schritte zum Refactoring kennen, soll im Folgenden erläutert werden, was ein atomares Refactoring überhaupt sein soll. Mit seinem Buch „Refactoring“ erklärt Martin Fowler, welche Möglichkeiten er ausgearbeitet hat ein Refactoring durchzuführen. Dabei beschreibt er zu jedem Refactoring, warum, wann und wie dieses Refactoring durchzuführen ist. Er gibt dabei konkrete Schritte an, die für ein bestimmtes Refactoring notwendig sind. Einige Refactorings sind sogar so einfach, dass sie bereits in einigen IDE's, wie IntelliJ automatisch ausgeführt werden können. Beispiele für solche automatischen Refactorings sind „Extract Function“ oder „Introduce Variable“. Das Refactoring „Extract Function“ nimmt einen festgelegten Codeblock und extrahiert diesen in eine Funktion. Die Stelle, wo der Codeblock zuvor stand, wird um einen Aufruf der Funktion ergänzt. Hier ein Beispiel:
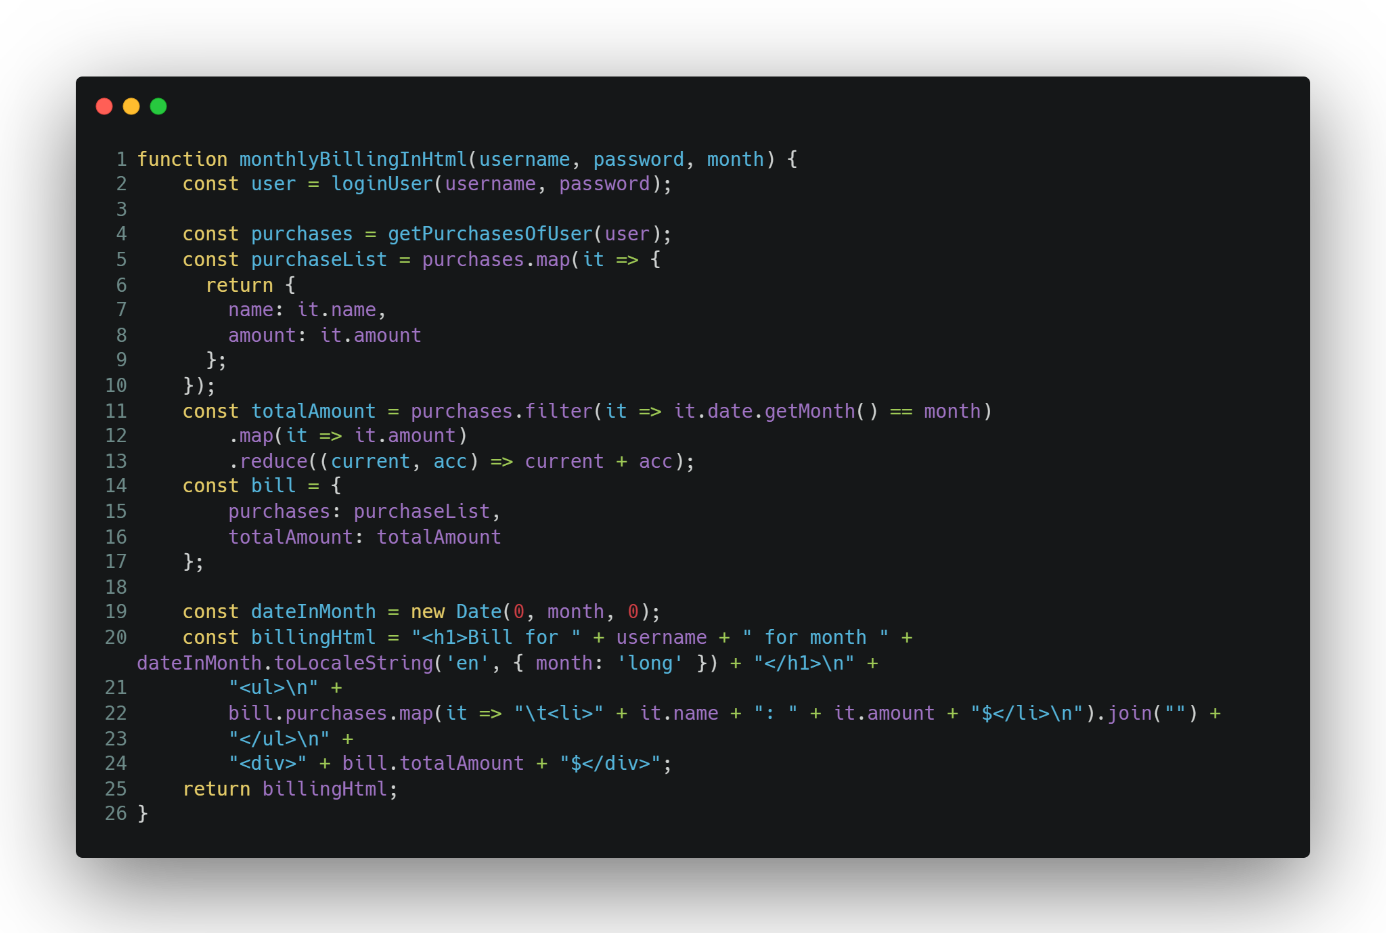
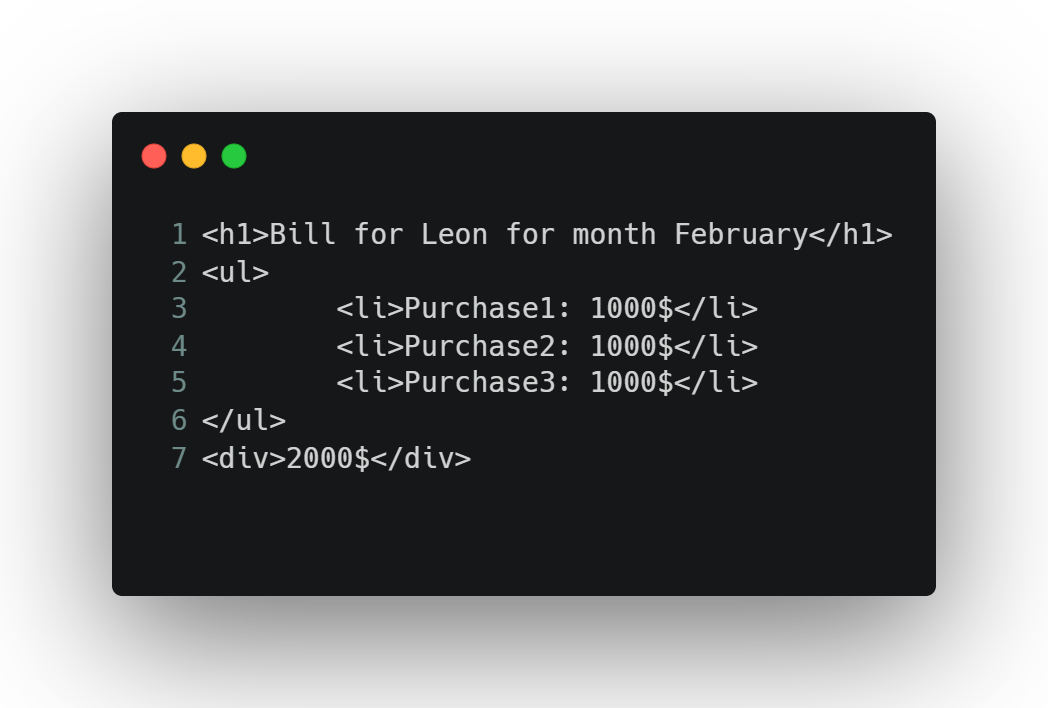
Diese Funktion gibt die Rechnung eines Online-Shops in HTML-Form zurück. Zuerst wird der Nutzer eingeloggt, um Zugriff auf das Nutzer-Objekt zu ermöglichen. Anschließend werden die Käufe dieses Nutzers abgefragt. Es wird ein Objekt erstellt, welches die Gesamtsumme der Kaufpreise enthält, sowie eine Auflistung der Namen und Preise der einzelnen Käufe. Zuletzt werden diese Daten in HTML-Form gebracht. Eine Mögliche Ausgabe dieses Codes ist:
Nun haben wir zwar Code, der funktioniert, wie er es sollte, aber die Funktion ist nicht besonders leserlich. Sie ist groß und macht gleich mehrere Dinge auf einmal. Das ist schon leicht daran zu erkennen, dass die Funktion aus drei Codeblöcken besteht: Einer in Zeile 2, einer von Zeile 4 bis 17 und einer von Zeile 19 bis 25. Mehrere Blöcke, wie diese, in einer Funktion sind immer ein Zeichen dafür, dass die Funktion zu viel auf einmal tut, und dass Teile der Funktion in separate Funktionen ausgelagert werden sollten. So können wir ebenfalls die zwei großen Codeblöcke auslagern, indem wir das Refactoring „Extract Function“ anwenden, welches in IntelliJ bereits automatisch durchgeführt werden kann. Zuerst führen wir das Refactoring für den zweiten Codeblock aus:
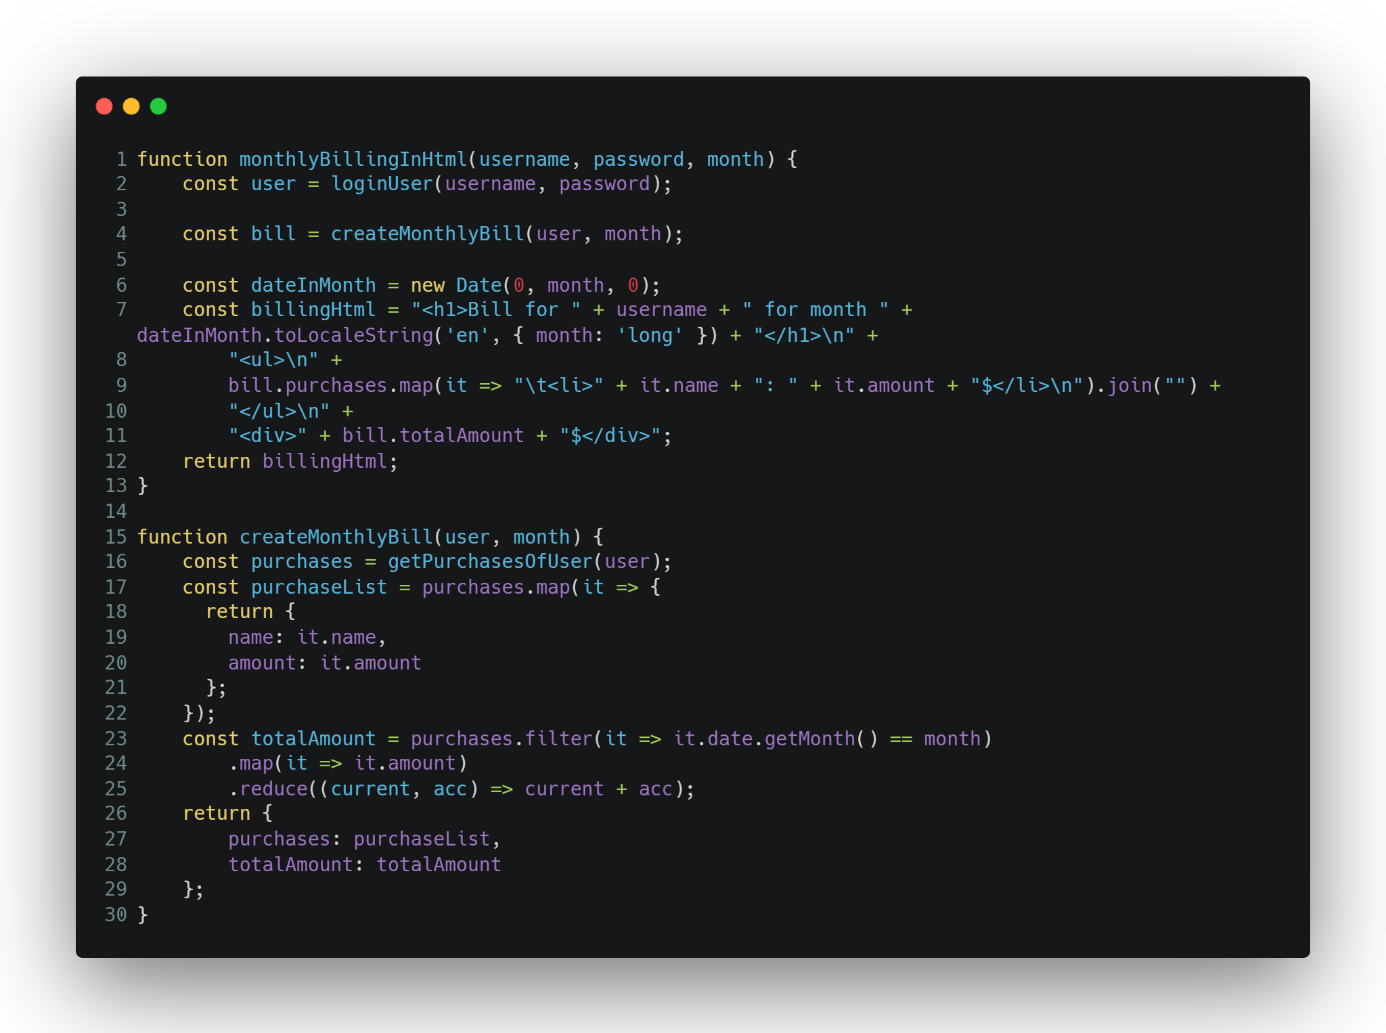
In Abbildung 3 können wir sehen, wie der Code nach dem Refactoring aussieht. Und nicht vergessen: Nach jedem Refactoring werden die Tests ausgeführt, die für den geänderten Code relevant sind. Wenn die Tests grün sind, dann wird commited. Anschließend extrahieren wir die Funktion createHtmlForBill(). Abbildung 4 zeigt das Resultat. Es ist nun auch bereits zu erkennen, dass wir mithilfe des Refactorings den Code zur Generierung der Rechnung, und den Code zum Generieren des HTMLs getrennt haben. Das hat den Vorteil, dass wir nun auch ganz einfach eine weitere Funktion schreiben können, um die Rechnung nicht in HTML-Form, sondern in einer beliebigen anderen Form darzustellen. So könnte eine weitere Funktion eine TXT-Datei generieren. Dies sei hier allerdings nur erwähnt. Wir konzentrieren uns weiter auf das Refactoring.
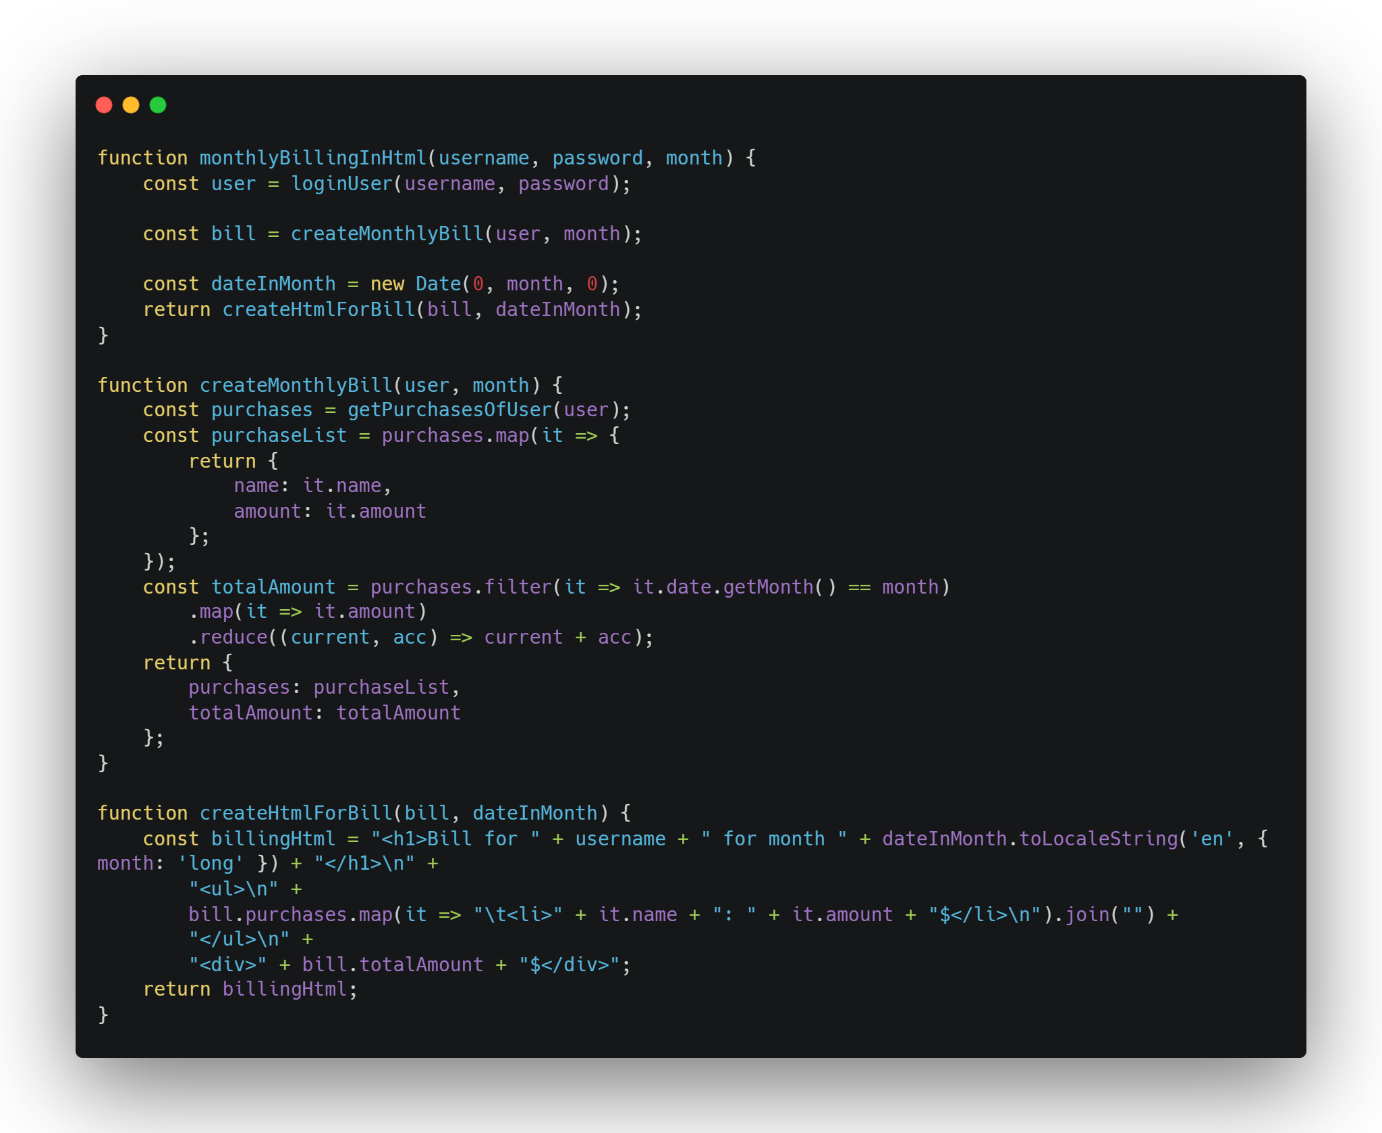
Wir können in Abbildung 4 sehen, dass die Funktion createHTMLForBill() ein Datum annimmt, und dieses in einen String umwandelt. Nun soll die Funktion allerdings nur die HTML-Darstellung generieren, und keine weitere Logik enthalten. Daher übergeben wir in Abbildung 5 das Datum in String-Form, und führen die Konvertierung bereits in monthlyBiillingInHtml() durch.
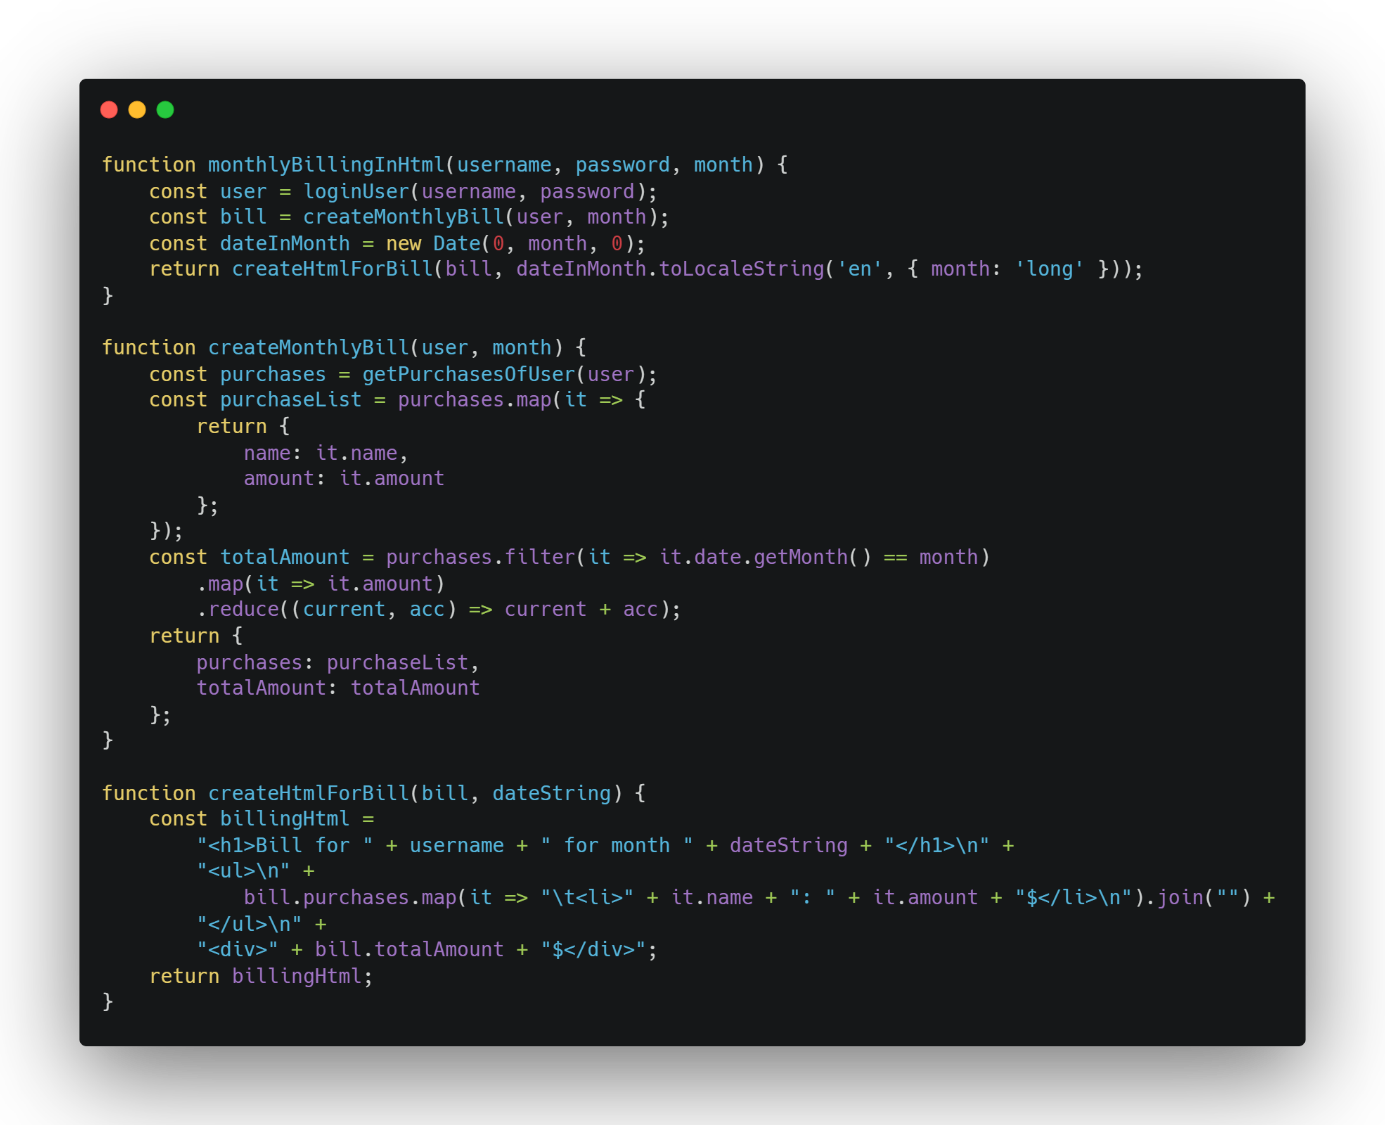
In nächsten Schritt können wir die Funktion monthlyBillingInHtml() erneut refactoren, indem wir „Inline Variable“ verwenden. An dieser Stelle werden manche Software-Entwickler protestieren, dass die Lesbarkeit der Funktion damit beeinträchtigt wird, weil die Variablennamen dabei helfen den Code zu verstehen. Durch ein „Inline Variable“ gehen die Variablennamen verloren. Grundsätzlich ist das ein gutes Argument und es ist immer auch situationsabhängig, ob ein solches Refactoring sinnvoll ist oder nicht. Hier gibt es leider nicht die eine korrekte Antwort auf die Frage, ob ein solches Refactoring sinnvoll ist oder nicht. An dieser Stelle habe ich es allerdings so gemacht. Das Ergebnis des Refactorings ist in Abbildung 6 zu sehen.
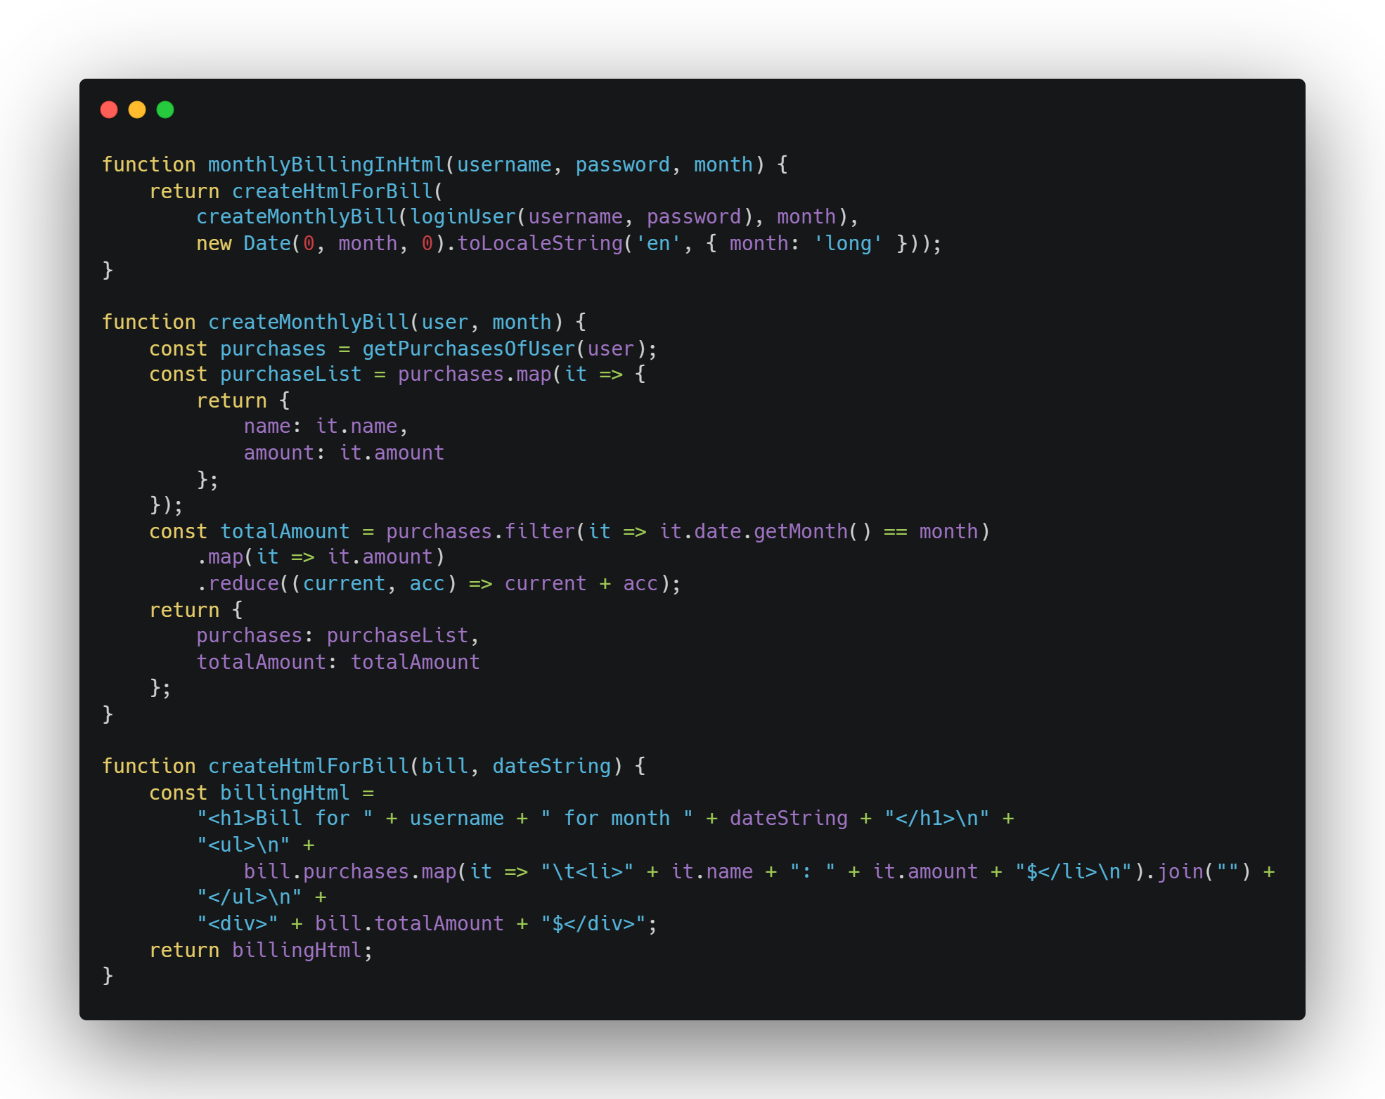
Die nächsten beiden Schritte zeigen den Vorteil von „Inline Variable“. Wir können nämlich nun im nächsten Schritt auch gleich den gesamten Methodenaufruf von loginUser() inlinen. Das Einloggen des Nutzers ist eine Precondition, welche für die Erstellung der Rechnung erfüllt sein muss. Bisher wurde diese Precondition durch monthlyBillingInHtml() erfüllt, nun aber durch createMonthlyBill() selbst. Das hat wiederum den Vorteil, dass Bugs vorgebeugt werden, welche entstehen könnten, wenn createMonthlyBill() an einer anderen Stelle im Code verwendet wird. Abbildung 7 zeigt den neuen Code.
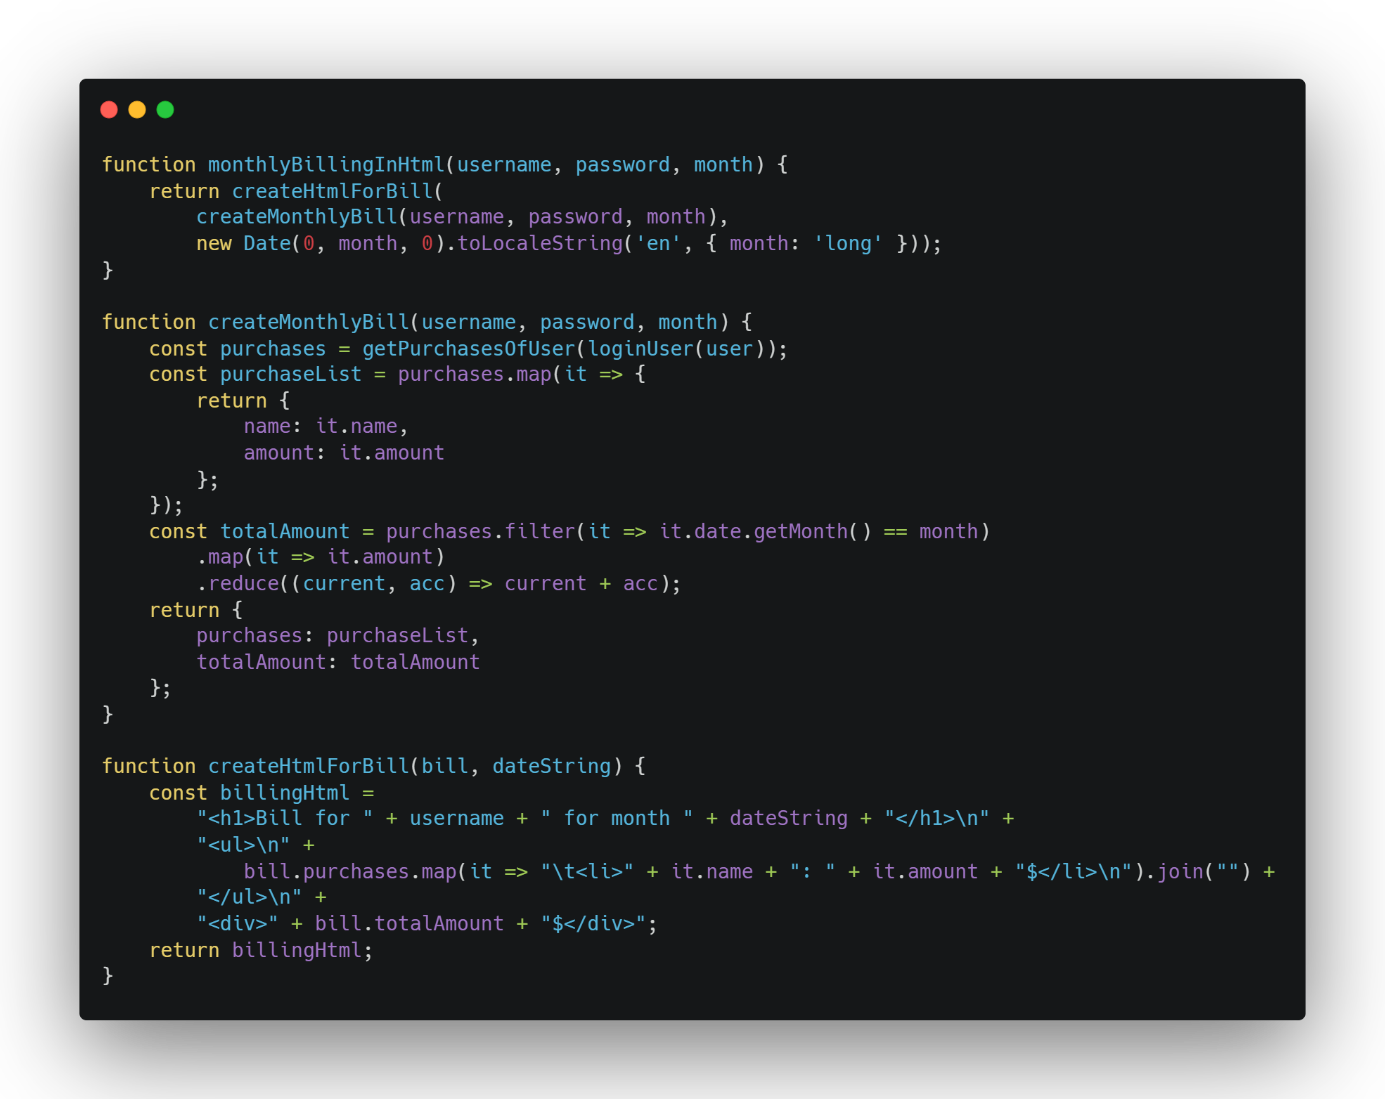
Zuletzt soll noch das Refactoring „Introduce Parameter Object“ angewendet werden. Wenn zuvor „username“ und „password“ als zwei Parameter übergeben wurden, sollen diese nun in einem Objekt „credentials“ vereint werden. Das soll den Codesmell einer zu langen Parameterliste verhindern und sorgt dafür, dass aus „username“ und „password“ eine logische Einheit wird. Der neue Code ist in Abbildung 8 zu sehen.
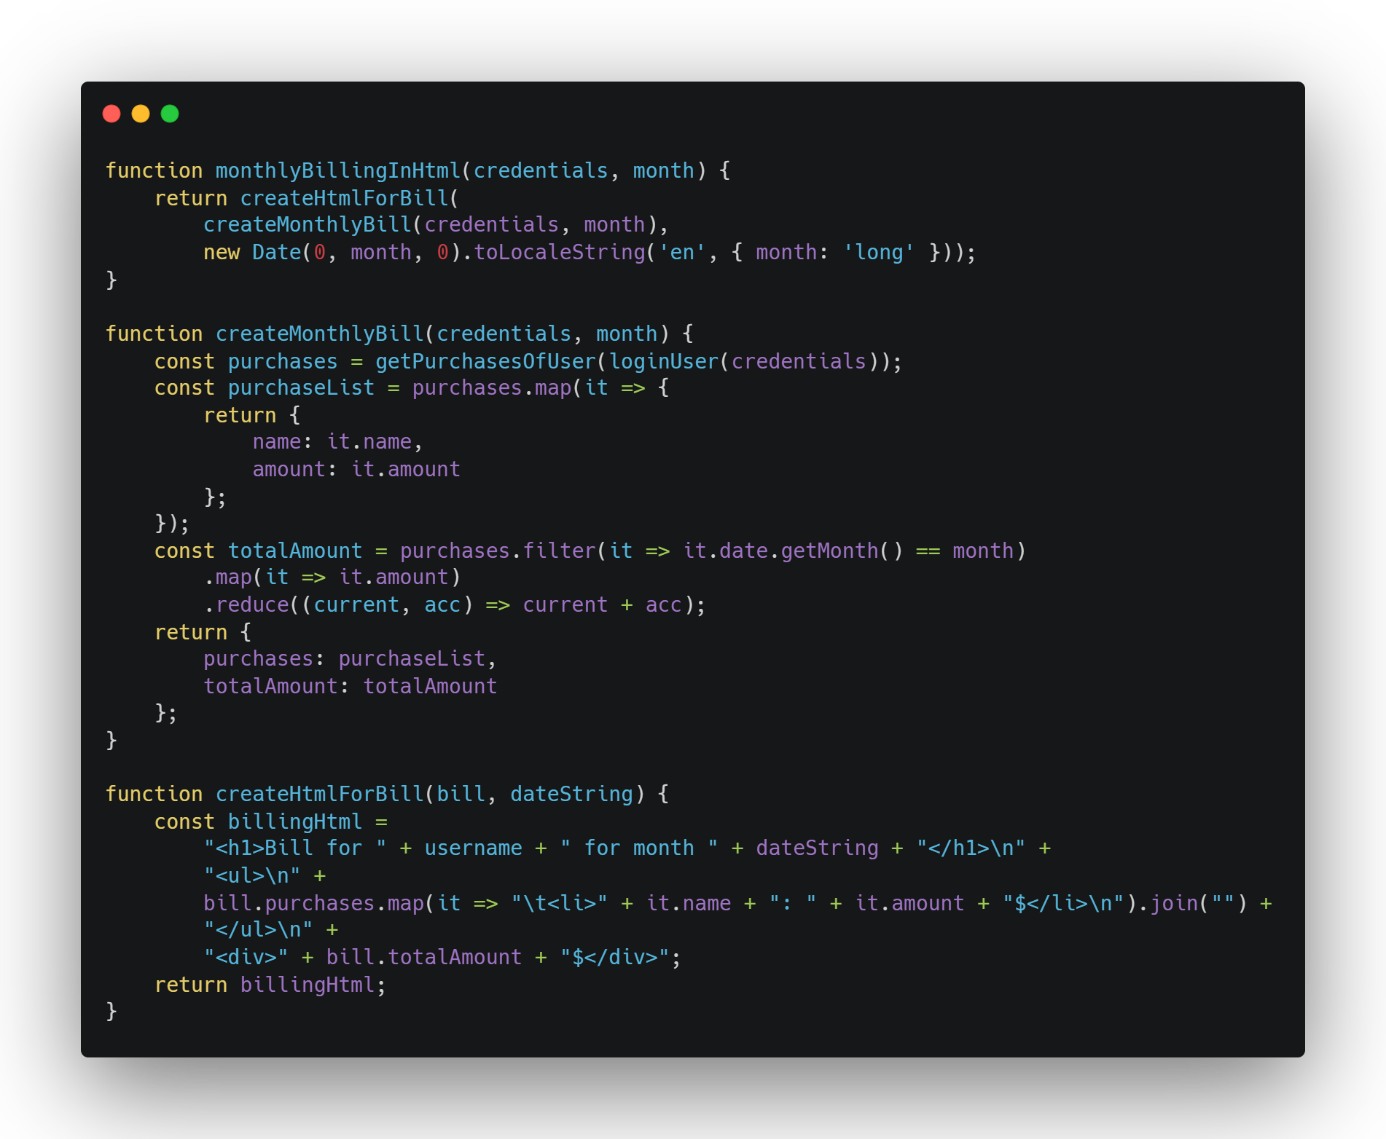
An dieser Stelle können noch viele weitere Refactorings durchgeführt werden. Um den Rahmen des Posts nicht zu sprengen, soll der Code aber so bleiben, wie er nun ist. Dieses Beispiel soll zeigen, wie da Refactoring von Code aussehen kann. Da das Beispiel sehr klein gehalten ist, kommt der Vorteil von Refactoring leider nicht so sehr zur Geltung, wie in einem tatsächlichen Projekt. Außerdem hat sich das Beispiel lediglich auf eine Handvoll Refactorings beschränkt. Wer sich weiter mit dem Thema beschäftigen möchte, der sollte in jedem Fall das Buch „Refactoring“ von Martin Fowler lesen, welches zuvor bereits erwähnt wurde. Ich hoffe, dass der Post den Nutzen von Refactorings gut verdeutlicht hat, und dass das Beispiel gut zu verstehen war.