Einleitung
Das manuelle Erstellen von Aufgaben für Klausuren und Übungen kann sehr zeitaufwändig und kompliziert sein. Studierende sollen die Möglichkeit bekommen, bestimmte Aufgabentypen intensiv zu üben. Dazu brauchen sie eine ganze Reihe von Aufgaben, welche das gleiche Thema behandeln, aber wiederum unterschiedlich anspruchsvoll sind. Für die manuelle Erstellung dieser Aufgaben müssen Experten herangezogen werden, und diese müssen viel Zeit in die Erstellung der Aufgaben investieren. Um die notwendige Zeit zur Generierung von Aufgaben zu reduzieren, können Systeme entwickelt werden, welche diese automatisch generieren. Diese Arbeit gibt einen Ausblick über die Möglichkeiten der automatischen Aufgabengenerierung im E-Assessment mithilfe von Natural Language Generation, kurz NLG. (REITER & DALE, 1997)
Das erste Kapitel untersucht beispielhafte Klausuren, um Aufgaben zu ermitteln, welche automatisiert werden sollen. Im Anschluss sollen mithilfe einer systematischen Literaturrecherche Möglichkeiten erörtert werden, um diese mithilfe von Techniken des Semantic Web und NLG automatisch zu generieren. Im Anschluss werden die dafür notwendigen Technologien erläutert, sodass am Ende genauer auf eine konkrete Implementierungsmöglichkeit der Aufgaben eingegangen wird.
Fachliche Anwendungsgebiete in der Informatik
Um einen Einstieg in das Thema zu bieten, sollen zunächst einige beispielhafte Klausuren betrachtet werden, welche in der Vergangenheit an der Universität Duisburg-Essen gestellt wurden und auf Studydrive zu finden sind. Die Wahl der Klausuren ist willkürlich.
Aus diesen Klausuren lassen sich verschiedenen Aufgaben ableiten. Dieses Kapitel soll lediglich der Identifikation von Aufgaben dienen. Das Kapitel „Multiple-Choice Aufgaben“ beschreibt anschließend einen Ansatz zur Generierung von Aufgaben näher im Detail.
Prüfung: Datenbankmanagementsysteme
Zuerst soll die Vorterminklausur des Sommersemesters 2019 im Modul Datenbankmanagementsysteme untersucht werden. Die erste Aufgabe der Klausur widmet sich SQL. Angegeben ist ein Datenbankschema. Studierende sollen SQL-Statements schreiben, um aus diesem Datenbankschema Informationen zu gewinnen. Welche Informationen das SQL-Statement abfragen soll ist in Fließtextform beschrieben.
In der dritten Aufgabe der Klausur werden DBMS-Konzepte behandelt. Dazu werden Fragen in Fließtextform gestellt. Die konkreten Fragen sind folgende:
- Was bedeutet logische Datenunabhängigkeit und wie wird diese in relationalen Datenbanken unterstützt?
- Was bedeutet referentielle Integrität und wie wird diese in relationalen Datenbanken garantiert?
- Warum sind Views im Allgemeinen nicht ausreichend, um externe und konzeptuelle Schicht zu trennen?
- Welche Eigenschaften haben Schlüsselkandidaten?
Die Antworten zu diesen Fragen müssen in Fließtextform angegeben werden. Aufgabe 6 der Klausur stellt unterschiedliche Fragen zum Thema Datenbankmanagementsysteme. Das sind die Fragen:
- Welche Isolationsstufen gibt es und welche Probleme lösen sie?
- Worin liegt der Vorteil in der Verwendung von PreparedStatements in JDBC (im Gegensatz zum gewöhnlichen Query)?
- Welches Problem gibt es bei NULL-Werten und JDBC und wie werden sie gelöst?
So, wie bei Aufgabe 3, werden diese Fragen in Fließtextformat beantwortet.
Prüfung: Software-Engineering
Als nächstes soll die Vorterminklausur von Software-Engineering aus dem Sommersemester 2019 betrachtet werden. Die Klausur behandelt überwiegend Definitionen aus dem Bereich der Software-Entwicklung. Die Aufgaben lauten wie folgt:
- Definition für die Begriffe Problem, Lösung, Anforderung
- Definition von Korrektheit, Zuverlässigkeit, Robustheit und warum kann nicht robuste Software trotzdem korrekt sein.
- Was ist ein Stakeholder und gib ein Beispiel? Erkläre den Anker-Effekt mithilfe eines selbst gewählten Beispiels.
- Erkläre was ein System, ein Systemkontext und die irrelevante Umgebung ist und wie diese sich abgrenzen.
Anschließend folgt die Aufgabe: Schreibe 2 User Stories für einen Live-Chat eines Online-Shops. Eine User Story hat immer die Form "Als <Rolle> möchte ich <Ziel/Wunsch>, um <Nutzen>".
Umsetzung
Da nun Aufgaben ermittelt wurden, welche automatisiert werden sollen, stellt sich die Frage, welche Ansätze zur Automatisierung es gibt. Eine systematische Literaturrecherche zur automatischen Generierung von Aufgaben mithilfe des Semantic Web und NLG hat die Umsetzung der Aufgaben in Form eines Multiple-Choice Formats als Ansatz ergeben. Mit dem Suchbegriff „semantic web nlg eassessment generation“ bei Google Scholar konnte das Paper „A Systematic Review of Automatic Question Generation for Educational Purposes“ von Kurdi et. al. ermittelt werden. Das Paper beschreibt Möglichkeiten zur automatischen Aufgabengenerierung. In den Quellen ist das Paper „Automatic generation of multiple choice questions using dependency-based semantic relations“ von Afzal und Mitkov zu finden. Dieses Paper beschreibt die Automatisierung von Aufgaben durch den Einsatz eines Multiple-Choice Formats, allerdings ohne den Einsatz von NLG. Durch den Suchbegriff „nlg mcq“ konnte wiederum das Paper „Automatic Generation Of Multiple Choice Questions From Domain Ontologies“ von Papasalouros et. al. ermittelt werden. Hier werden Multiple-Choice Aufgaben, kurz MCQs, mithilfe von NLG generiert.
In den folgenden Kapiteln soll es also darum gehen, wie das Semantic Web und NLG eingesetzt werden können, um MCQs zu generieren, um damit
eine Grundlage für die Implementierung der, in diesem Kapitel identifizierten, Aufgaben zu geben. Dazu ist ein Verständnis von NLG und des
Semantic Web nötig. Das nächste Kapitel „Natural Language Generation“ erklärt daher, wie natürliche Sprache generiert wird. Im Anschluss
wird das Semantic Web erläutert. Zuletzt folgt das Kapitel „Multiple-Choice Aufgaben“.
Natural Language Generation
Das Themengebiet NLG befasst sich mit der Generierung von natürlicher Sprache. Es ist neben Natural Language Understanding, welches sich dem Verständnis von natürlicher Sprache widmet, ein Teilgebiet von Natural Language Processing. Natural Language Processing, kurz NLP, ist also eine Sammlung von Algorithmen zur automatischen Analyse und Generierung von natürlicher Sprache. (Chowdhary, 2020, p.� 604)
NLG lässt sich konzeptuell grundsätzlich als das Mapping von Inputdaten zu Outputdaten verstehen. Es ist üblich dieses Mapping-Problem in einzelne Unterprobleme zu unterteilen. Die Outputs des vorangehenden Schrittes sind dabei der Input für den nächsten Schritt. (REITER & DALE, 1997, p.� 64)
Ein NLG-System kann in seiner Komplexität sehr unterschiedlich sein. Ein einfacher Ansatz zur automatischen Generierung von natürlicher Sprache ist der template-based approach. Hier werden vorgefertigte Sätze gebildet und lediglich Variablen an Stellen eingefügt, an denen dies notwendig ist. (Kapoor, 2021) Die Grenzen dieses Ansatzes lassen sich einfach demonstrieren. Der Output des Templates „Markus hat <Anzahl Kinder> Kinder“ ist beispielsweise grammatikalisch falsch, wenn Markus lediglich ein Kind besitzt. In diesem Fall wird <Anzahl Kinder> durch eins ersetzt und das Ergebnis ist der Satz „Markus hat eins Kinder“. Der Einsatz des template-based approach kann für MCQs ausreichend sein, wie das Kapitel „Multiple-Choice Aufgaben“ demonstrieren wird.
Dennoch soll im Folgenden ein Algorithmus beschrieben werden, welcher Sätze generieren kann, die flexibler in ihrem Inhalt sind und auch grammatikalisch angepasst werden können. Denn auch wenn eine einfache Satzgenerierung für MCQs ausreichen kann, wie es nachfolgende Beispiele zeigen werden, sind komplexere Satzgenerierungen in MCQs nicht auszuschließen. Ein Beispiel für ein MCQ mit komplexeren Sätzen ist das Scrum Open Assessment. Das Scrum Open Assessment ist thematisch etwas anderes als die hier betrachteten Klausuren, soll aber als Beispiel dafür dienen, dass MCQs grundsätzlich auch komplexere Sätze beinhalten können. Dabei ist unter einfacher Satzgenerierung zu verstehen, dass ein Template zur Generierung ausreicht. Wenn sich verschiedene Antwortmöglichkeiten in ihrem Satzbau grundsätzlich unterscheiden, dann muss auch dieser flexibel angepasst werden können, sodass die Generierung des Satzes komplex ist. Es gilt zu beachten, dass die Begriffe der einfachen und komplexen Satzgenerierung hier nur der Verständlichkeit dienen sollen, und keine festgelegten Definitionen sind.
Figure 1 stellt die einzelnen Schritte dieses Algorithmus in einer sehr abstrakten Form dar. Es werden die Schritte Text Planner, Sentence Planner und Linguistic Realiser durchlaufen. Der Input für den Text Planner ist der gewünschte Inhalt des Textes, also eine Beschreibung dessen, wovon der Text handeln soll. Dieser erste Schritt des Festlegens des Inhalts wird als Content Determination bezeichnet. Der nächste Schritt, Text Planning, bestimmt die Reihenfolge, in welcher diese Informationen übermittelt werden sollen. Das Ergebnis ist ein Text Plan. Ein Text Plan speichert Informationen und deren Beziehungen zueinander mithilfe einer Baum-Datenstruktur. Die Leafs dieses Baumes sind die eigentlichen Informationen. Die restlichen Nodes des Baumes beschreiben, wie diese Informationen miteinander verbunden sind. (REITER & DALE, 1997, p.� 73)
Danach müssen die Informationen entsprechend in Paragraphen und in Sätze eingeteilt werden, und es müssen Konjunktionen zur Verbesserung der Lesbarkeit eingebaut werden� (Sentence Planning). Das Ergebnis ist ein Sentence Plan, welcher, so wie der Text Plan auch, seine Informationen in Form einer Baum-Datenstruktur speichert. Letztlich müssen durch den Linguistic Realiser die Sätze grammatikalisch korrekt zusammengefügt werden. (Kapoor, 2021)
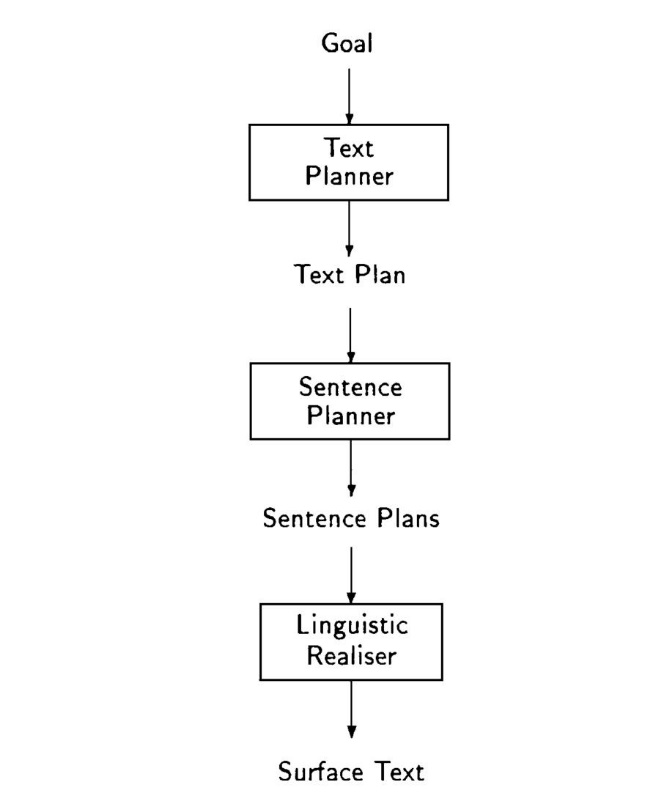
Figure 1: Reiter, Dale 1997 - Architektur eines NLG-Systems (REITER & DALE, 1997, p.� 69)
Die einzelnen Schritte, die bereits betrachtet wurden, sind noch sehr abstrakt und lassen sich in weitere Unterschritte unterteilen. Die weiteren Unterschritte sind das bereits genannte Content Determination, sowie Discourse Planning, Sentence Aggregation, Lexicalization, Referring Expression Generation und Realisation. Dabei ist Discourse Planning Teil des Text Planners, Sentence Aggregation Teil des Sentence Planners und die übrigen Schritte Teil des Linguistic Realisers.
Content Determination fokussiert sich auf das Filtern und Zusammenfassen von Eingabedaten, anhand dessen eine Nachricht in Form einer formalen Sprache generiert wird. Die formale Sprache beschreibt Entitäten, Konzepte und Beziehungen. (REITER & DALE, 1997, p.� 65)
Es folgt der Schritt des Discourse Planning. Hier wird bestimmt, in welcher Reihenfolge die Daten, die im Schritt Content Determination bestimmt wurden, dargestellt werden sollen. (REITER & DALE, 1997, p.� 66) Die Informationen im Discourse Planning sind dabei nicht unabhängig voneinander, sondern sie haben Beziehungen zueinander. (REITER & DALE, 1997, p.� 73) Die Aussage� "Ich habe morgen keine Zeit, weil ich meine Seminararbeit schreiben muss" besteht aus zwei Informationen:� "Ich habe morgen keine Zeit" und "Ich muss morgen meine Seminararbeit schreiben". Ersteres ist eine Behauptung, zweiteres eine Begründung. Die Begründung bezieht sich auf die Behauptung. Eine andere Art von Beziehung zwischen Informationen ist eine Erklärung, oder ein Beispiel. Es gibt eine ganze Reihe von Beziehungen zwischen Informationen, auf die im Rahmen dieser Arbeit aber nicht weiter eingegangen werden soll. Eine bekannte Technik zur Implementierung von Discourse Planning sind Schemas. Schemas beschreiben die Art und Weise, wie ein Text Plan aufgebaut werden kann, ähnlich wie die Grammatik einer formalen Sprache. (REITER & DALE, 1997, p.� 75)
Bei der Verwendung von Schemas ist es nicht ungewöhnlich, dass die beiden Schritte Content Determination und Discourse Planning vereint werden, um den Text Plan zu generieren. Durch die Struktur des Schemas wird bereits festgelegt, welche Informationen überhaupt kommuniziert werden können. Ebenso die Reihenfolge in welcher die Informationen kommuniziert werden. (REITER & DALE, 1997, p.� 75)
Der nächste Schritt der Sentence Aggregation gruppiert diese Informationen anschließend in Sätze. Dazu wird als Input das Ergebnis des Discourse Planning verwendet. (REITER & DALE, 1997, p.� 66) Eine einfache Form von Sentence Aggregation ist, einen Satz für jede Information zu generieren. Oftmals ist es allerdings sinnvoll dies nicht zu tun, sodass die Lesbarkeit des Textes erhöht wird. (REITER & DALE, 1997, p.� 66) Der generierte Text Plan wird als Input für den Schritt Sentence Aggregation verwendet. Die Baumstruktur des Text Plans, welcher beschreibt welche Informationen auf welche Art kombiniert werden sollen, wird gemappt auf eine Baumstruktur, dessen Leafs schlussendlich als Sätze realisiert werden. In diesem Schritt muss also bestimmt werden, welche Informationen als ein Satz realisiert werden sollen und auf welche Art und Weise die Informationen verbunden werden sollen. (REITER & DALE, 1997, p.� 76) Nehmen wir beispielsweise die zwei Informationen "Markus geht spazieren" und "Markus findet einen 5€ Schein auf dem Boden". Wir haben unterschiedliche Möglichkeiten diese Informationen zu aggregieren. Wir können zwei Sätze verwenden und sagen:� "Markus geht spazieren. Er findet einen 5€ Schein auf dem Boden". Wir können diese Informationen aber auch einfach als einen Satz realisieren und sagen:� "Markus geht spazieren und findet einen 5€ Schein auf dem Boden".
Danach folgt der Schritt der Lexicalization. Beim Lexicalization Schritt werden die abstrakten Informationen durch konkrete Wörter und Phrasen ersetzt. (REITER & DALE, 1997, p.� 67) Eine einfache Form der Lexicalization ist, die Informationen hard-coded durch Wörter zu ersetzen. Um die Lesbarkeit des Textes zu verbessern kann es aber ratsam sein, unterschiedliche Wörter für die gleichen Konzepte zu verwenden. (REITER & DALE, 1997, p.� 67)
Nun sind die Informationen in Sätze gruppiert und es wurde bestimmt, welche Wörter verwendet werden sollen. Allerdings besteht das Problem, dass Nomen immer wieder verwendet werden, und nicht die Bezugswörter er, sie, es verwendet werden, die die Lesbarkeit verbessern würden. Im Schritt Referring Expression Generation werden Domain Entitäten identifiziert, sodass diese nicht jedes Mal beim Namen genannt werden müssen, sondern durch Wörter, wie er, sie, es referenziert werden können. Beispielsweise kann der Text "Markus geht spazieren. Markus findet einen 5€� Schein auf dem Boden" umgeschrieben werden in:� "Markus geht spazieren. Er findet einen 5€� Schein auf dem Boden". Die Lesbarkeit des Textes wird damit verbessert. (REITER & DALE, 1997, p.� 67)
Der letzte Schritt, Linguistic Realisation, wendet� letztendlich Grammatikregeln an, um beispielsweise das Wort Zug in Züge umzuwandeln, wenn es sich um eine Mehrzahl von Zügen handelt. (REITER & DALE, 1997, p.� 68)
Dieses Kapitel hat die Struktur eines NLG-Systems genauer erläutert. Diesem NLG-System können nun Daten bereitgestellt werden, sodass das NLG-System einen Text in natürlicher Sprache generieren kann. Die notwendigen Daten können manuell bereitgestellt werden, aber für die vollständig automatische Generierung von Aufgaben muss auch dieser Schritt automatisch erfolgen. Das nächste Kapitel erklärt, wie die notwendigen Inputs für das NLG-System automatisch aus dem sogenannten Semantic Web abgefragt werden können.
Semantic Web
Für die Generierung von Text mithilfe von NLG muss zunächst bestimmt werden, was der Text beinhalten soll. Um letztlich dynamisch Aufgaben generieren zu können, welche eine natürlichsprachige Form haben, braucht es also eine Möglichkeit auch diesen Inhalt dynamisch zu bestimmen. Aus dem Semantic Web können mithilfe von SPARQL Queries Sachzusammenhänge jeglicher Form abgefragt werden, welche anschließend mithilfe eines NLG-Systems in Fließtext umgewandelt werden können. Das bedeutet, dass ein System auf Grundlage des Semantic Webs und NLG einen Fließtext, oder auch eine Frage, zu einem beliebigen Thema generieren kann.
Klassisch bestehen Websites aus Inhalten, wie Überschriften, Paragraphen und Bildern. Dabei wird die Website vom Nutzer als eine eigenständige Einheit wahrgenommen, die lediglich über das Web gefunden werden kann, allerdings keinen Zusammenhang mit anderen Inhalten im Web hat. Mit Ontologien wird das Web um diesen Zusammenhang erweitert.
Der Begriff Semantic Web ist in dem Sinne irreführend. Denn unter Semantic Web wird nicht nur die Erweiterung des Webs um den Sinn von sprachlichen Zeichen verstanden, sondern es wird auch hierunter auch die Erweiterung des Webs um die Beziehungen zwischen Zeichen und Objekten verstanden. (Pellegrini, 2006, p.� 22) Semantik bezeichnet den Sinn von sprachlichen Zeichen (Pellegrini, 2006, p.� 21)
Ontologien
Der Begriff Ontologie kommt ursprünglich aus der Philosophie und behandelt die Konzeptualisierung von Kategorien. In der Informatik wurde der Begriff adaptiert. Hier werden Konzepte, Objekte, Beziehungen und Attribute beschrieben.
Die Ontologie beschränkt sich auf das zugrundeliegende Datenmodell der Inhalte, und beschreibt noch nicht den Prozess, der diese Daten in eine gut verständliche Darstellung zu bringen. (Pellegrini, 2006, p.� 25) Ontologien werden im Semantic Web dazu verwendet, dass Maschinen die Beziehungen zwischen Inhalten verstehen. Wenn eine Maschine dies tut, dann kann sie bereits eigenhändig Zusammenhänge verstehen, ohne dies dem Nutzer zu überlassen. (Pellegrini, 2006, p.� 24) Ontologien bieten also eine Möglichkeit viele Informationen zu kombinieren und diese in eine bestimmte Form zu bringen oder daraus neue Informationen zu generieren.
Das Semantische Web soll Informationen von unterschiedlichen Quellen, wie Websites, kombinieren, und damit die Informationen in einen Kontext einordnen. Websites sollen nicht einfach Texte beinhalten, sondern es soll auch Informationen zusätzlich zu dem Text geben, welche diesem einen Kontext verleihen. (OWL Web Ontology Language Guide, 2017) Mithilfe dieses Kontexts soll dem Inhalt eine explizite Bedeutung gegeben werden. Und wenn die Zusammenhänge von Informationen bekannt ist, dann können damit Aufgaben, wie MCQs generiert werden.
Eine beispielhafte Multiple-Choice Aufgabe könnte folgendes sein: Welches der folgenden Wörter ist eine Isolationsstufe?
- Read Uncommitted
- DBMS
- Informatik
- CRUD
Die Antwort auf diese Frage ist offensichtlich (a). Doch interessanter als die korrekte Antwort ist hier die Art und Weise, wie die Aufgabe gelöst wird. Um diese Aufgabe zu lösen, muss ein Mensch die Zusammenhänge dieser Wörter verstehen. Er braucht Informationen über die Beziehungen der einzelnen Wörter zueinander, dessen Ontologie. Er muss verstehen, dass die Wörter DBMS, Informatik und CRUD zu einer anderen Gruppe gehören, und keine Isolationsstufen sind. Read Uncommited ist dagegen eine Isolationsstufe. Informationen wie diese lassen sich anhand eines Netzwerkes beschreiben, wobei jeder Knotenpunkt ein Wort ist, und jeder Pfeil von Wort A zu Wort B dessen Beziehung zueinander (Figure 2). Die Erweiterung des Webs um die Semantik soll es einer Maschine ermöglichen, auf die gleiche Art und Weise Schlüsse zu ziehen, wie es ein Mensch tut.
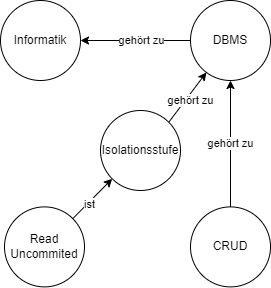
Figure 2: Beispielhafte Ontologie
Um das Web um die Semantik zu erweitern, werden Metadaten verwendet. Metadaten sind Daten über Daten. Eine Maschine weiß zunächst nicht, dass der String "Mo 21.06.2006, 09:30" eine Datumsangabe ist. Dies muss der Maschine mitgeteilt werden. (Pellegrini, 2006, p.� 23) Also wird der String um Metadaten erweitert, sodass die Maschine weiß, dass es sich hier um eine Datumsangabe handelt. So kann eine Website einen String beinhalten, welcher eine Datumsangabe ist, und diesen String um Metadaten erweitern, sodass auch Maschinen verstehen, dass der String eine Datumsangabe ist. Die Definition von diesen Metadaten sind allerdings nicht auf der Website selbst zu finden, sondern an einer anderen Stelle im Web.
Dieses Kapitel hat erklärt, was Ontologien sind, und dass Metadaten verwendet werden, um das Web um die Semantik zu erweitern. Das nächste Kapitel soll erläutern, wie RDF verwendet wird, um diese Metadaten bereitzustellen.
RDF
Um die Daten des Semantic Web zu speichern, wird ein standardisiertes Format, das Resource Description Framework (RDF), verwendet. Dieses Format speichert die semantische Beschreibung von Daten in Form von "Subjekt - Prädikat - Objekt" Tripeln. Das Subjekt und das Objekt sind Entitäten, das Prädikat eine Beziehung zwischen den beiden Entitäten. (Striewe, 2019, p.� 2)
Properties beschreiben eine Beziehung zwischen einer Resource und einem Objekt. Ein Objekt kann entweder eine weitere Ressource sein oder ein Literal. Beispielsweise kann es die Property "ist Teil von"� geben. Dann kann mit diesem Property ausgedrückt werden, dass eine Ressource A ein Teil von Ressource B ist: <URI von Ressource A> "ist Teil von" <URI� von Ressource B>. Andererseits kann mit der Property ausgedrückt werden, dass eine Ressource, welches eine Website ist, ein Teil des Webs ist:� <URI> "ist Teil von" "Web". In diesem Fall ist das Objekt des RDF-Triples das Literal "Web". (Resource Description Framework (RDF) Model and Syntax Specification, 2017)
RDF� unterscheidet zwischen drei Typen von Objekten:� Resources, Properties und Statements. Ressourcen können ganz unterschiedliche Elemente sein, welche im Web zu finden sind. Es könnte sich um eine Website, oder nur einen Teil einer Website handeln. Es könnte sich auch um eine PDF-Datei handeln. Eine Ressource wird immer mit einem Uniform Resource Identifier (URI) referenziert. (Resource Description Framework (RDF) Model and Syntax Specification, 2017)
Ein Statement ist ein RDF-Triple in seiner Gesamtheit. Also ein Subjekt, ein Prädikat und ein Objekt, wie in den vorangegangenen Beispielen. (Resource Description Framework (RDF) Model and Syntax Specification, 2017)
Um Ontologien zu beschreiben, reicht RDF alleine noch nicht aus. Denn RDF bietet keine Möglichkeit mögliche Entitäten oder Beziehungen zu definiert. Hierzu werden RDF-Schemas (RDFS) verwendet. Ein RDF-Schema definiert die möglichen Ressourcen, die RDF� beschreiben kann, sowie die möglichen Properties, die eine Ressource haben kann. (Resource Description Framework (RDF) Schema Specification, 2017)
Die Informationen werden in RDF-Form in einer Knowledge Base gespeichert. Eine Knowledge Base ist eine Datenbank, welche Wissen in Form eines semantischen Netzes speichert. Bekannte Knowledge Bases sind Wikidata, DBpedia und WordNet. Wikidata ist eine freie Open Knowledge Base, welche als zentraler Speicher von Strukturierten Daten der Wikimedia Projekte, also Wikipedia, Wikivoyage, Wikisource, usw., fungiert. (Wikidata, 2022) DBpedia bietet die gleiche Funktionalität wie Wikidata. WordNet ist eine Plattform, auf welcher Nomen, Verben und Adjektive in Synonymsets gruppiert werden. (Brown et al., 2005, p.� 820) Ein Synset reflektiert eine gemeinsame Bedeutung von unterschiedlichen Wörtern. Zwischen Synsets kann es unterschiedliche Beziehungen geben. (Brown et al., 2005, p.� 820)
Um die RDF-Daten aus den Knowledge Bases abzufragen, wird die Query Language SPARQL verwendet. Dieses soll im nächsten Kapitel behandelt werden.
SPARQL
SPARQL� ist eine Query Language zur Abfrage von RDF-Daten. (Pérez et al., 2009, p.� 1) Es� ist eine graph-matching Query Language. Queries in SPARQL� bestehen aus drei Teilen. Zum einen der pattern-matching Teil, welcher bestimmt, welche Daten abgefragt werden sollen. Es werden dabei genau die Daten abgefragt, welche auf alle Patterns passen. Die Patterns bestehen dabei aus Triples, also "Subjekt Prädikat Objekt" Aussagen. Diese Aussagen können auch als OPTIONAL markiert werden. Darüber hinaus kann auch nach bestimmten Werten gefiltert werden. Neben dem Pattern-Matching gibt es die Solution Modifier. Diese geben an, welche von den abgefragten Werten durch die� Query zurückgegeben werden sollen. Die Werte können dabei mit den Keywords PROJECTION, DISTINCT, ORDER� und LIMIT� angepasst werden. Zuletzt bestehen SPARQL� Queries aus dem Ausgabetypen. So gibt es Ja/Nein Queries, SELECT Queries oder Queries, welche neue RDF-Daten generieren. (Pérez et al., 2009, p.� 2)
Multiple-Choice Aufgaben
Bevor die technische Umsetzung von MCQs beschrieben wird, soll zunächst geklärt werden, wie diese eigentlich funktionieren und was beachtet werden muss. Die Art der Fragen und möglichen Antworten eines MCQ muss an das Verständnisniveau des Studierenden angepasst sein. Je nachdem wie gut sich ein Studierender in einem Thema auskennt, hat er ein niedrigeres oder höheres Verständnisniveau. Nach Bloom‘s Taxonomie werden die Niveaus Wissen, Verständnis, Anwendung und Analyse unterschieden. Die Fragen von MCQs können sich auf unterschiedliche Verständnislevel konzentrieren. (Cubric, 2011, pp.� 6–7) Bei der automatischen Generierung von MCQs muss also zuerst bestimmt werden, welches Verständnisniveau des Studierenden abgefragt werden soll. Dabei ist fraglich, wie sinnvoll die Verwendung von MCQs für Niveaus ist, die über das Niveau von Wissen hinausgehen. Dennoch werden diese auch für höhere Niveaus verwendet. (Cubric, 2011) Wenn das notwendige Verständnisniveau bestimmt ist, dann kann der eigentliche Test generiert werden.
Mithilfe von Ontologien besteht die Möglichkeit eine Domäne in Form einer "Concept Map" zusammenzufassen. MCQs können auf Grundlage dieses Wissens generiert werden, sodass der Einsatz von Ontologien in diesem Bereich als sinnvoll erachtet wird. Anschließend wird mithilfe eines NLG-Systems, welches eine Ontologie als Input erhält, eine konkrete Frage generiert. (Andreas Papasalouros, Konstantinos Kanaris, Konstantinos Kotis, 2008, p.� 2)
Hier kommen die zuvor behandelten Inhalte zum Semantic Web ins Spiel. Zunächst muss mithilfe einer Query eine Ontologie aus dem Semantic Web abgefragt werden. Diese Ontologie enthält Begriffe, und dessen Beziehungen zueinander. Sie sind bereits semantisch verknüpft. Einige dieser Begriffe könnten sogar Synonyme sein, sodass sie besonders geeignet für die Generierung von schwierigen MCQs sind. Denn die Herausforderung von MCQs ist es die korrekte Antwort von den falschen Antworten zu unterscheiden. Und je ähnlicher sich die Antwortmöglichkeiten sind, desto schwieriger ist auch die Unterscheidung. Die Qualität von MCQs hängt von der Qualität der falschen Antwortmöglichkeiten ab. (Emmanuel Anastas Mbawala, p.� 10) Es muss nun also auf Grundlage der Ontologie eine Fragestellung generiert werden, und die möglichen Lösungen müssen eine gewisse Ähnlichkeit besitzen.
MCQs können durch eine Klassenstruktur abgebildet werden, welche in Figure 3 zu sehen ist. Es gibt eine Klasse Test, welches mehrere Instanzen der Klasse Question enthält. Es gibt eine n-m Beziehung zwischen der Klasse Question und der Klasse Answer. Jede Question hat also keine, eine oder mehrere Antworten. Von der Klasse Question leitet sich die Klasse MultipleChoiceQuestion ab. Diese besitzt als Attribut die Klasse Stem, welches die textuelle Repräsentation der Frage darstellt. Daneben besitzt die MultipleChoiceQuestion eine korrekte Antwort und eine oder mehrere falsche Antworten, welche durch die Klassen Key (korrekte Antwort) und Distractor (falsche Antwort) dargestellt werden. (Cubric, 2011, p.� 4)
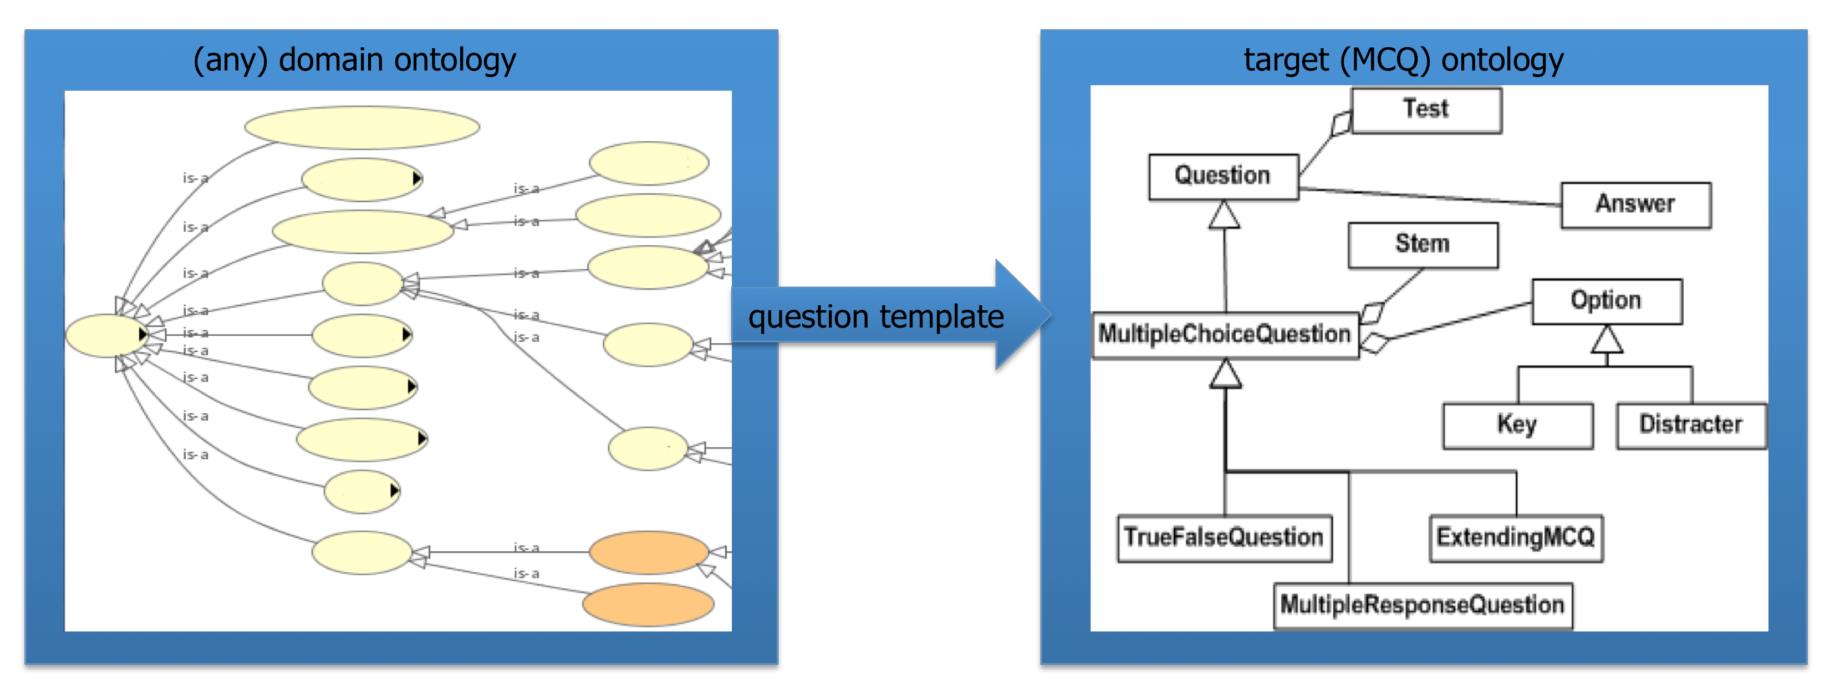
Figure 3: Mapping von Domain Ontology auf MCQ Ontology (Cubric, 2011, p.� 4)
Anhand von einer Ontologie werden Instanzen dieser Klassen erstellt und der Test wird befüllt. Zur Generierung der Fragestellung und der Antwortmöglichkeiten kann beispielsweise ein beliebiges Triple aus der Ontologie abgefragt werden. So könnte ein RDF Triple genommen werden, welches die Information darüber repräsentiert, dass „Read Uncommited“ eine Isolationsstufe ist, sodass die Aufgabenstellung wie folgt aussieht:
- Stem: „Welche der folgenden Antwortmöglichkeiten ist eine Isolationsstufe?“
- Korrekte Antwort: Read Uncommited
Im Anschluss müssen Distractors generiert werden. Um geeignete distractors für eine Multiple-Choice Aufgabe zu finden ist es notwendig, ein Ähnlichkeitsmaß zu bestimmen, anhand dessen sich die Ähnlichkeit der distractors zu der korrekten Frage messen lässt. Das� Leacock-Chodorow Maß und das Jiang-Contrath Maß sind Beispiele für Ähnlichkeitsmaße. (Emmanuel Anastas Mbawala, p.� 10) Es soll im Folgenden nicht weiter auf die Details der Ähnlichkeitsmaße eingegangen werden. Grundsätzlich hängt die Ähnlichkeit zwischen Begriffen damit zusammen, durch wie viele Beziehungen die Begriffe in einer Ontologie voneinander getrennt sind. Die Entitäten „Read Uncommited“ und „Read Commited“ haben beide die Beziehung „ist ein“ zu der Entität „Isolationsstufe“. Sie haben eine hohe Ähnlichkeit. Zwischen den Begriffen „Read Uncommited“ und „Informatik“ liegt eine weitaus größere Distanz in der Ontologie. Denn „Read Uncommited“ ist eine „Isolationsstufe“, eine „Isolationsstufe“ ist ein Konzept aus „Datenbankmanagementsystem“ und „Datenbankmanagementsystem“ ist ein Konzept in „Informatik“.
Zur Generierung der Fragestellung und der Distractors gibt es die class-based, property-based und terminology-based Strategien. Hier soll auf die class-based Strategie eingegangen werden. Bei ihr werden Ontologien auf die „is-a“-Beziehung untersucht. Es werden Instanzen zu Klassen gesucht. So lässt sich beispielsweise die Aufgabe in dieser Form generieren:
- Stem: „Welche der folgenden Aussagen ist korrekt?“
- Korrekte Antwort: „Read Uncommited ist eine Isolationsstufe“
Hier ist die Instanz „Read Uncommited“ und „Isolationsstufe“ ist die Klasse. Die Generierung der Distractors erfolgt, indem eine Superklasse von „Isolationsstufe“ gesucht wird, beispielsweise „Datenbank“. Nun wird eine Instanz aus der Klasse „Datenbank“ als Distractor eingesetzt: „Postgres ist eine Isolationsstufe“. (Andreas Papasalouros, Konstantinos Kanaris, Konstantinos Kotis, 2008, pp.� 3–4) Antwortmöglichkeiten haben das Template: „<Instanz> ist ein <Klasse>“. Wie bereits in dem Kapitel „Natural Language Generation“ thematisiert, hat der template-based approach (im Kontext von NLG) zur Implementierung dieser Aufgabe den Nachteil, dass Sätze nicht grammatikalisch angepasst werden. Bereits eine einfache Aufgabe wie diese benötigt einen Lingustic Realiser, um eine korrekte Antwortmöglichkeit zu generieren. Hierfür kann SimpleNLG eingesetzt werden. Papasalouros et. al. demonstrieren die Verwendung von SimpleNLG zur automatischen Generierung von MCQs.
Fazit
Diese Arbeit hat einen Einblick in die Möglichkeiten der automatischen Aufgabengenerierung mithilfe von NLG gegeben. Die Generierung von natürlicher Sprache erfolgt über ein NLG-System. Als Input für das NLG-System können Ontologien verwendet werden, welche zuvor mithilfe von SPARQL aus dem Semantic Web abgefragt wurden. Diese Ontologien stehen in Knowledge Bases wie Wikidata oder DBpedia zur Verfügung. Diese Technologien können verwendet werden, um MCQs zu generieren. Es können Ontologien aus dem Semantic Web abgefragt werden, auf dessen Basis Maschinen die Sachzusammenhänge der abgefragten Konzepte verstehen können, und eine Frage, sowie die entsprechenden Antwortmöglichkeiten, generieren können. Dies ermöglicht wiederum die automatische Generierung von Aufgaben, welche beispielsweise in der Vorterminklausur des Sommersemesters 2019 im Modul Datenbankmanagementsysteme, oder in der Vorterminklausur von Software-Engineering aus dem Sommersemester 2019, zu finden sind.